Altro giro di sperimentazione home-made, sperando di rendervi partecipi dell’entusiasmo!
Cari colleghi e non, lo sappiamo bene, nella TC (e soprattutto nell’ambito cardiaco), la risoluzione spaziale non basta mai.
Calcificazioni coronariche di un millimetro, stent, placche vulnerabili: tutto si gioca su pochi voxel che possono essere determinanti.
Snoccioliamo il discorso andando alla base dell’immagine: i voxel dipendono essenzialmente da due scelte che facciamo a valle dell’acquisizione, nella fase di ricostruzione: la matrice e il kernel.
Quindi mi sono posto la domanda
Se non abbiamo a disposizione i dati grezzi ?
Se abbiamo solo una ricostruzione “morbida” a kernel standard o peggio a matrice ridotta, una rete neurale può indovinare con buona approssimazione la ricostruzione più nitida a matrice piena? E soprattutto, quanto fa meglio della classica “interpolazione bicubica” che Photoshop ci ha fatto amare negli anni 2000?
 512
1024 SwinIR
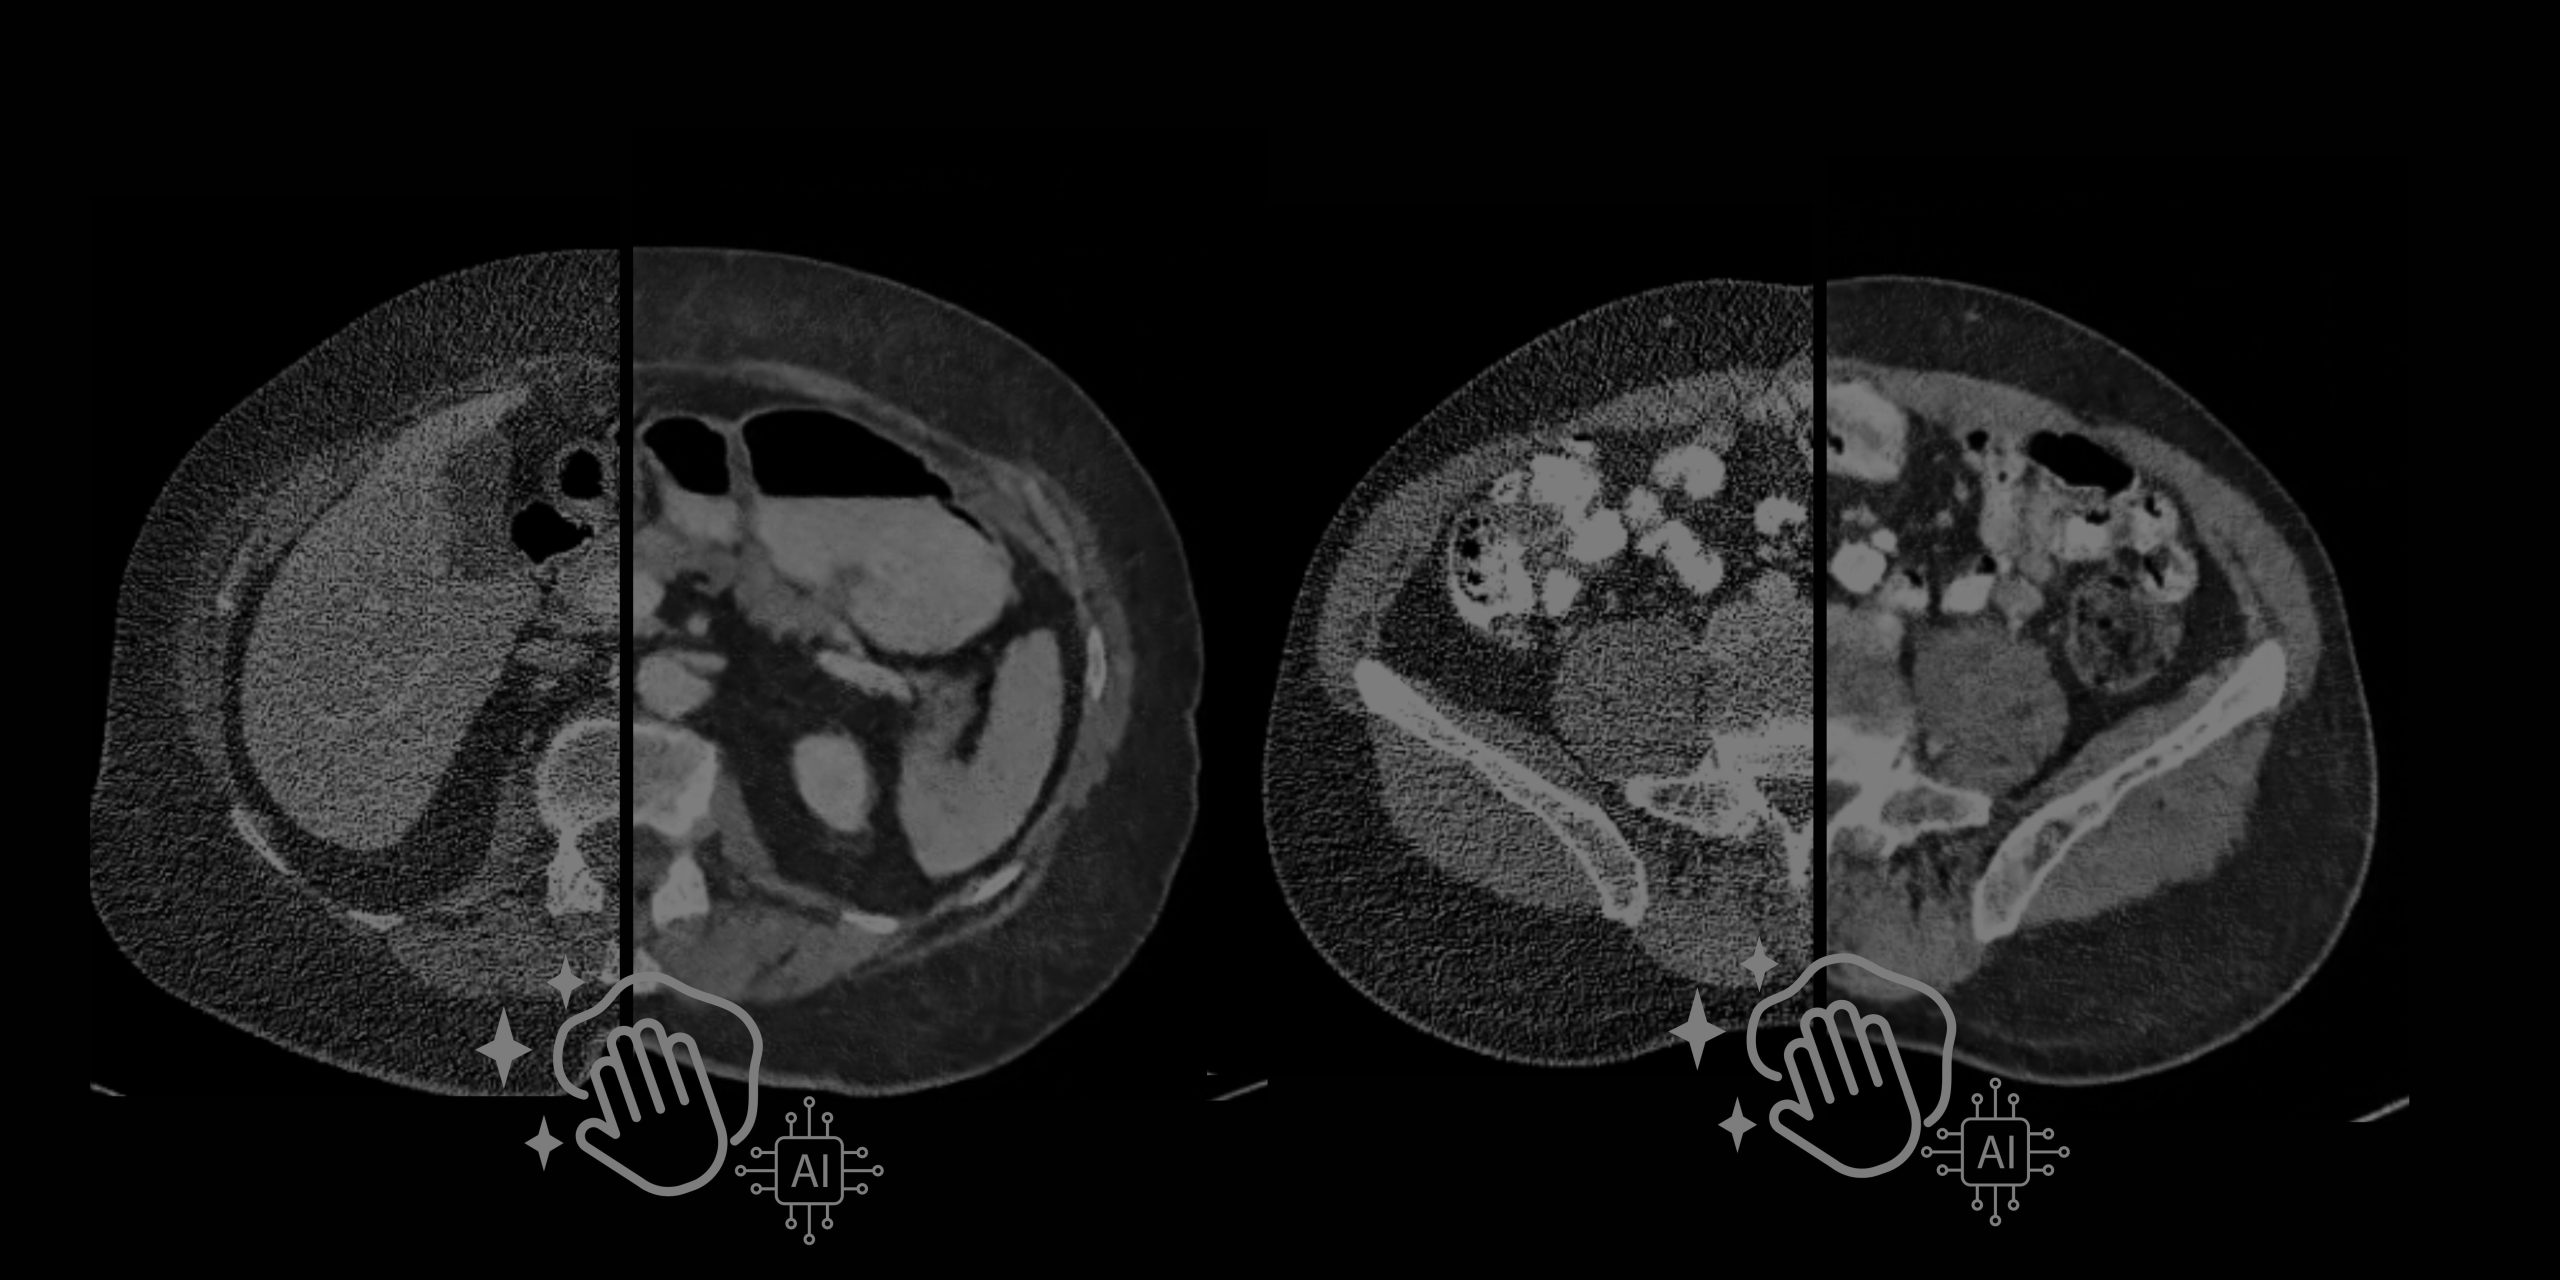
Ecco un assaggio di quello di cui vi parlo oggi.
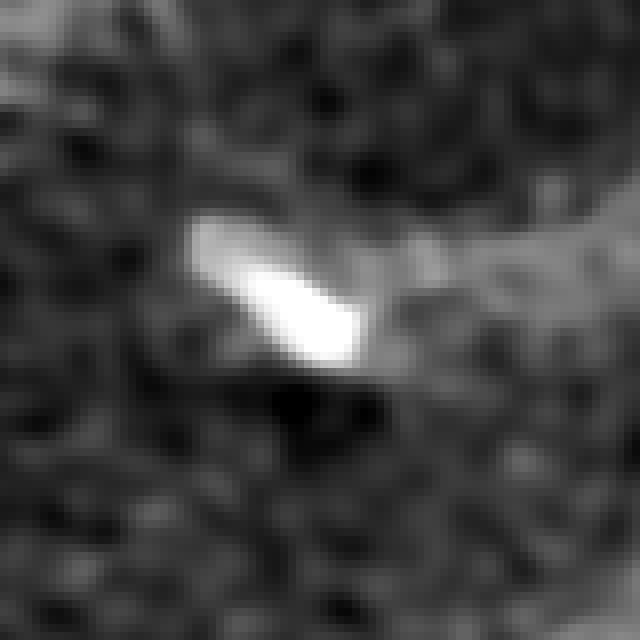
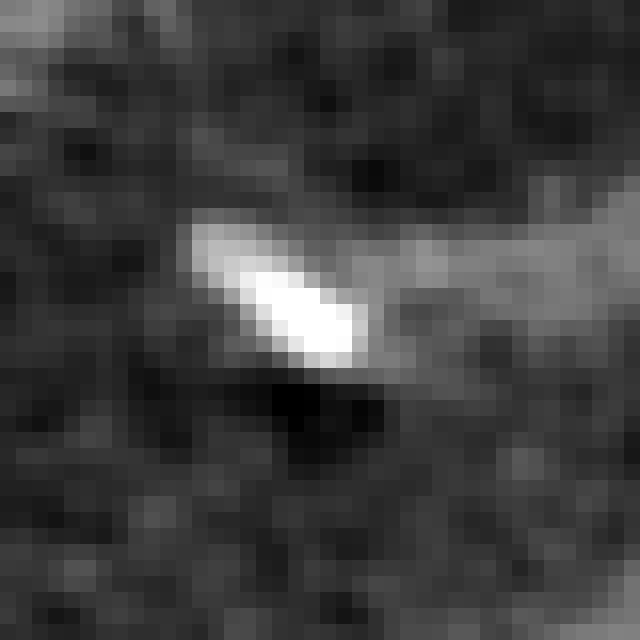
Raggiungere un livello di risoluzione maggiore (nel contesto qui sopra passando da un’immagine 512×512 a 1024×1024) attraverso il fine-tuning di una rete neurale dedicata e confrontando i risultati con l‘interpolazione bicubica.
In tutto l’articolo sono presenti immagini a scorrimento che si confrontano trascinando la linea a sinistra o a destra. Con il pulsante sotto (ove presente) si può cambiare l’immagine di confronto a destra.
Partiamo dal basso – Matrice low res (256) a una super resolution (1024): cosa succede ai pixel
Lasciamo un FOV uguale per tutti dettagli; quello che varia è il numero di pixel che compongono le immagini. Sul paziente di test il FOV è di 213 mm, quindi nella ricostruzione low resolution a 256×256 ogni pixel misura 0,83 mm. Parimenti, a 512 avremo 0,43 mm e a 1024 appena 0,21 mm. Una calcificazione di 2 mm passa così da 2-3 pixel a oltre una decina.
Vediamolo più chiaramente con un esempio reale
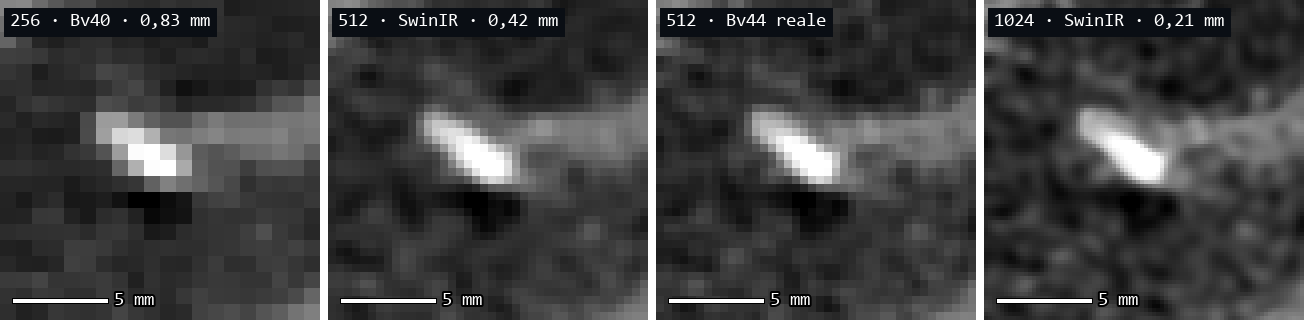
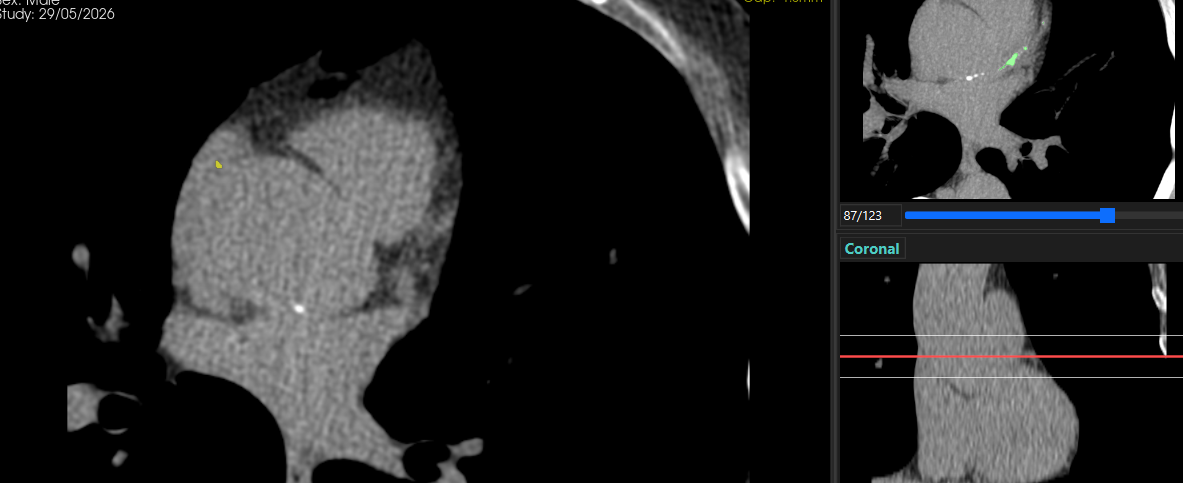
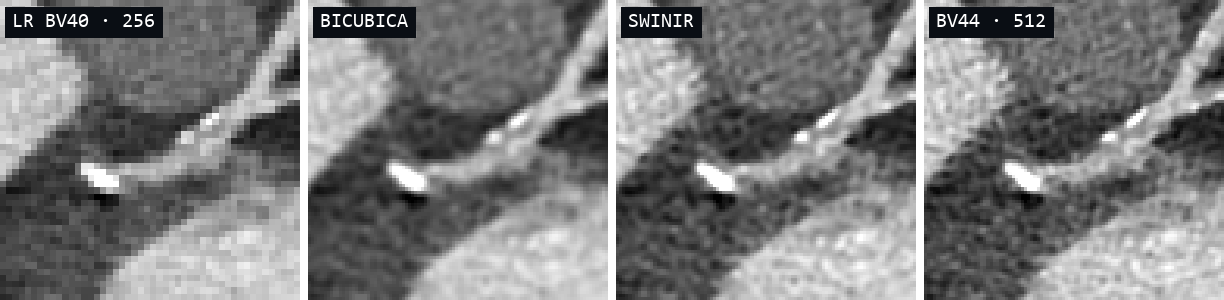
Nella prima immagine a matrice 256×256 il crop dimostra la calcificazione che conserva il suo contrasto ad alta densità, ma non permette di riconoscerne i bordi.
La seconda immagine è l’applicazione della rete neurale (ri)addestrata sulla matrice low-res e dimostra già un drammatico aumento della risoluzione spaziale che è del tutto similare alla sua controparte reale ricostruita a 512×512 a kernel più sharp (Bv44). L’ultima immagine è una successiva riapplicazione della rete neurale per raggiungere una matrice di 1024×1024.
Il punto chiave è comprendere come vengono riempiti i pixel nuovi all’aumento di matrice. Un’interpolazione come la bicubica li calcola come una media pesata dei vicini: l’immagine diventa più grande ma non contiene informazione nuova, quindi i bordi restano sfumati. Una rete di super-resolution ha imparato da migliaia di esempi che aspetto abbia la versione ad alta risoluzione di una certa struttura “disegnando” i pixel nuovi.
Il passaggio da 256 a 512 si può verificare, perché la vera 512 esiste; quello da 512 a 1024 no, e ci torneremo alla fine.
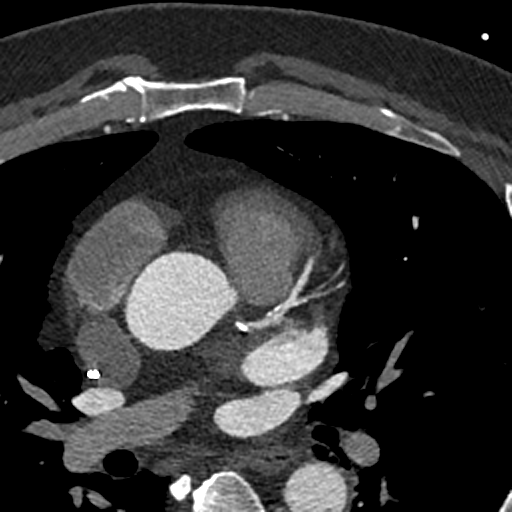
Sulla slice intera la differenza tra bicubica e SwinIR è meno apprezzabile che nei crop, ma c’è. Con il pulsante sotto è possibile inserire nel confronto a destra la ricostruzione “vera” a 512 x 512 (cioè quello che entrambi i metodi cercano di indovinare e che compareremo successivamente anche a livello quantitativo)
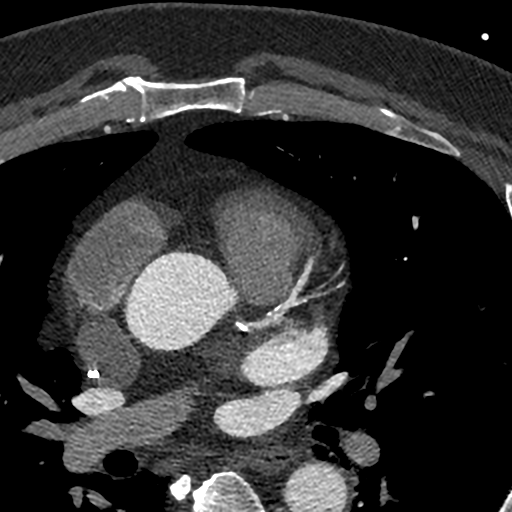
 Bicubica
SwinIR
Il problema: matrice e kernel
Lo stesso set di dati grezzi può essere ricostruito in tanti modi. In questo esperimento ho allestito un dataset di 10 cardio-TC anonimizzate ricostruite in due modalità:
- LR: kernel Bv40, matrice 256 × 256. Più liscia – pixel grandi (circa 0,8 mm sul campo di vista del paziente di test).
- HR: kernel Bv44, matrice 512 × 512. Più nitida (ma rumorosa) – pixel con dimensioni della metà (circa 0,4 mm).
Il compito della rete quindi non è solo “raddoppiare i pixel” (super-resolution ×2), ma anche passare da un kernel all’altro: deve imparare che aspetto ha un bordo, una calcificazione o la grana del rumore quando la ricostruzione è più spinta.
L’interpolazione bicubica, per definizione, non può farlo: interpola tra i pixel che ci sono e basta. Il risultato è un’immagine sì più grande, ma con ovvia diminuizione delle alte frequenze a causa delle media dei pixel più vicini.
Il dataset
Il dataset (cardiac-ct-lr-hr, pubblico su Kaggle) comprende le coppie di cardio-TC appaiate con kernel Bv40 e Bv44, spessore 0,6 mm, incremento 0,4 mm, per un totale di 4.076 coppie di slice. Prima di tutto ho verificato che le coppie combaciassero davvero: stessa posizione in z, stesso campo di vista (tra 156 e 233 mm a seconda del paziente) e pixel spacing della LR esattamente doppio rispetto alla HR. Se i pixel non corrispondono, la rete impara a spostare l’immagine invece che a migliorarla.
Splitting del fine-tuning per paziente:
7 pazienti per l’addestramento, 1 per la validazione, 2 (mai visti dalla rete) per il test.
Il modello destinatario del fine-tuning: come funziona SwinIR
SwinIR (Liang et al., 2021) è un’architettura per il restauro delle immagini basata sui Swin Transformer. Un Transformer classico (come quello già trattato in un articolo precedente) mette in relazione ogni pixel con tutti gli altri che su una slice a 512 significherebbe oltre 260000 pixel.
SwinIR ha un approccio molto più parsimonioso e furbo, dividendo l’immagine in finestre di 8 × 8 pixel e calcolando l’attenzione solo dentro ciascuna finestra. La genialata sta nello strato successivo, spostando la griglia di mezza finestra: i confini cambiano e l’informazione passa da una finestra all’altra. Ripetendo questo schema la rete costruisce un contesto sempre più ampio senza esplodere in memoria e permettendo l’addestramento anche con risorse computazionali minori.
Questa piccola animazione cerca di spiegare in modo più dettagliato come avviene il processo
1. Un’immagine fatta di quadratini. Ogni quadratino è un pixel e ha un solo valore di densità, in unità Hounsfield (HU). A matrice 256 un pixel copre 0,83 mm: quello evidenziato vale 406 HU. Per passare a 512 va diviso in 4 pixel più piccoli. Ma che valore dare a ciascuno?
2. Il metodo classico: fare la media. L’interpolazione bicubica calcola i 4 valori nuovi come una media pesata dei pixel vicini. È veloce, ma non aggiunge informazione: l’immagine diventa più grande e i bordi restano sfumati.
3. La rete guarda il contesto. SwinIR divide l’immagine in finestre di 8 × 8 pixel. Dentro ogni finestra ogni pixel “guarda” gli altri e stabilisce quanto contano per lui: è il meccanismo di attenzione. Un po’ come fa l’occhio del radiologo, che per capire dove passa il bordo di una calcificazione guarda anche tutto ciò che ha intorno.
4. Le finestre si spostano, e si ricomincia. Al giro successivo la griglia si sposta di mezza finestra, così l’informazione passa da una finestra all’altra. Il lavoro si ripete 36 volte, e a ogni giro ogni pixel “conosce” una zona più ampia attorno a sé.
5. Disegnare i nuovi pixel. Alla fine ogni pixel diventa un quadrato di 2 × 2. Questa volta i valori non sono medie: sono quelli che, secondo quanto la rete ha imparato, avrebbe una vera ricostruzione a 512. Il nostro pixel da 406 HU era il bordo di una calcificazione, metà calcio e metà tessuto: SwinIR lo separa come la Bv44 reale, la bicubica lo lascia sfumato.
6. Come ha imparato. Durante l’addestramento la rete ha visto 48.000 coppie di ritagli dello stesso punto, a 256 e a 512. Ogni volta confronta il suo risultato con la 512 vera, misura l’errore e corregge di pochissimo i suoi parametri. Dopo 6.000 giri ha imparato il passaggio.
La struttura ha tre parti.
Una convoluzione 3×3 estrae le feature “superficiali”, cioè bordi e contrasti locali. Poi vengono 6 blocchi RSTB (Residual Swin Transformer Block), ciascuno con 6 strati di attenzione a finestre e una propria connessione residua. Infine c’è la ricostruzione: le feature profonde si sommano a quelle iniziali e un pixel shuffle trasforma ogni pixel in un quadratino 2 × 2, raddoppiando la matrice. In totale sono circa 12 milioni di parametri.
Stavolta, rispetto all’esperimento precedente, non sono partito da zero.
Ho usato la versione SwinIR-M ×2 già addestrata dagli autori per la super-resolution classica sul dataset DIV2K.
DIV2K però contiene fotografie, non TC: paesaggi, persone, edifici, a colori e a 8 bit. Per usarla sulle TC servono due adattamenti:
- HU al posto dei colori: i valori in unità Hounsfield vengono normalizzati tra −1024 e 3071 (l’intervallo completo, non una finestra, così non si perde nessuna densità) e ovviamente replicati sui tre canali RGB che la rete si aspetta. In uscita si fa la media dei tre canali e si torna in HU.
- Una prova “zero-shot”, cioè con i pesi originali e nessun addestramento sulle TC. Spoiler alert: Già così la rete batte la bicubica: l’RMSE scende da 26,95 a 21,73 HU. Quello che ha imparato sulle fotografie su bordi e texture vale in parte anche per le TC.
Il fine-tuning, passo per passo
La rete “zero-shot” non è addestrata su immagine radiologiche nè ha mai preso contatto con le differenze di kernel e della differenza tra rumore e dettaglio. Il fine-tuning serve proprio a questo: è una sorta di (ri)addestramento partendo dai parametri sviluppati in DIV2K (i cosiddetti pesi) aggiustandoli con le coppie vere Bv40 → Bv44.
In questo contesto, a differenza della volta precedente, si procede a un learning rate sensibilmente basso, così la rete conserva quello che sa già imparando solo le differenze.
I dati che vede la rete
- Patch, non slice intere. A ogni passo si estraggono 8 patch casuali di 64 × 64 pixel dalla 256 e le corrispondenti 128 × 128 dalla 512, perfettamente allineate. Patch piccole permettono batch più grandi e moltiplicano gli esempi.
- Pazienti pesati per numero di slice. Prima si sceglie il paziente, in proporzione alle sue slice, poi una slice a caso.
- Niente patch d’aria. Se la media della patch è sotto −900 HU (quasi solo aria fuori dal paziente) se ne pesca un’altra, fino a 10 tentativi: l’aria contiene voxel bassi e troppo uniformi e falserebbe la perdita.
- Data augmentation. Rotazioni di 90° e ribaltamenti casuali, applicati identici alla patch LR e alla HR. Non ci sono rotazioni arbitrarie né cambi di intensità, che altererebbero gli HU o la geometria dei pixel.
Come impara
- Perdita L1, cioè l’errore assoluto medio tra uscita e Bv44 vera. Rispetto all’errore quadratico (L2) è meno indulgente con le immagini “medie” e sfocate ed è più robusta ai pixel estremamente iperdensi come metallo e calcio.
- Ottimizzatore AdamW con learning rate 2 × 10⁻⁴: sale linearmente nelle prime 200 iterazioni (warm-up, per non stravolgere subito i pesi pre-addestrati) e poi scende a zero con un andamento a coseno.
- 6.000 iterazioni da 8 patch
- Precisione fp32. Con la mezza precisione (fp16), più veloce, l’attenzione di SwinIR va in overflow e produce NaN esplodendo. Chi va piano, va sano e va lontano.
Come si sceglie il modello finale
Ogni 500 iterazioni la rete viene valutata sul paziente di validazione, che non entra mai nell’addestramento: 40 slice distribuite su tutto il volume, misurando il PSNR nel corpo in finestra cardiaca. Il checkpoint definitivo è quello che ha il PSNR migliore. Notare come la distribuzione del PSNR già intorno alla 3000sima iterazione inizia ad essere stabile.
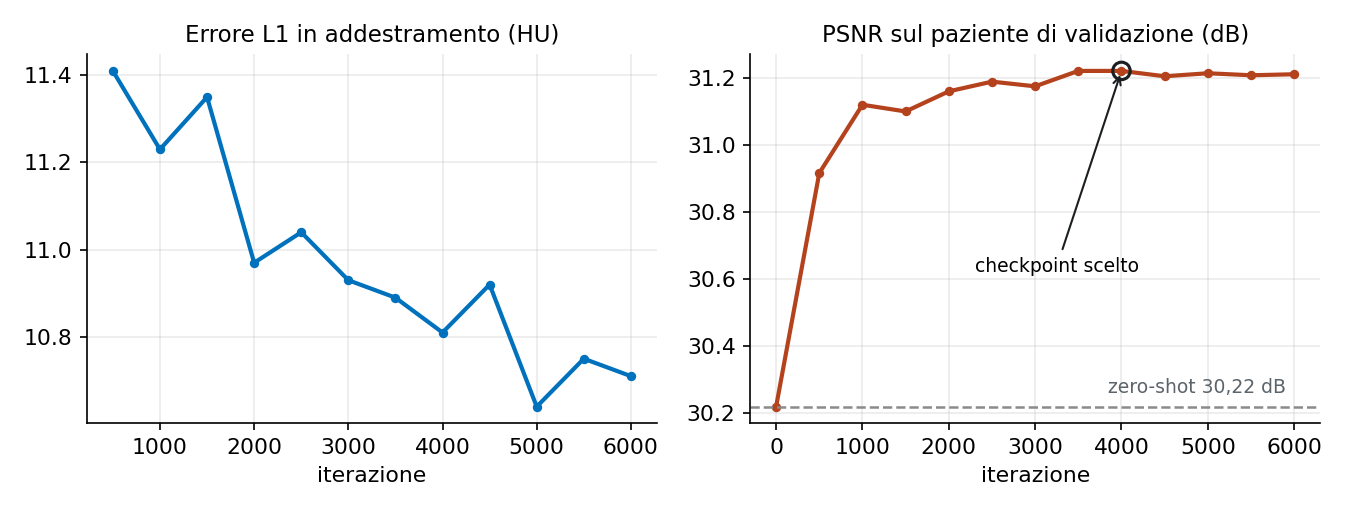
Quasi tutto il guadagno è arrivato nelle prime 1.000 iterazioni: il PSNR di validazione passa da 30,22 dB (zero-shot) a 31,12 dB. Poi la crescita rallenta, fino al massimo di 31,22 dB intorno alla 4.000isima iterazione restando piatta anche se l’errore L1 continua a scendere.
Tutto l’esperimento è stato effettuato in un notebook Kaggle che vi condivido.
Due GPU Tesla T4 gratuite: circa 85 minuti di addestramento, più fase di valutazione e export.
Il notebook salva i checkpoint, le immagini di confronto e test in PNG ed effettua un’inferenza di test su un caso del dataset esportando i DICOM.
I numeri – Come facciamo a sapere quantitativamente com’è andata ?
Utilizzeremo tre parametri:
RMSE: di quanto si sbaglia, in media, ogni pixel
Si prende pixel per pixel la differenza tra l’immagine ottenuta e quella vera. Si eleva al quadrato, si fa la media e poi si estrae la radice. Il risultato è nella stessa unità dell’immagine, cioè in unità Hounsfield.
Più basso è, meglio è. Immaginiamolo come una sorta di deviazione standard tra le due immagini, solo che invece di misurare il grado di allontanamento dalla media, noi misuriamo quanto si allontanano dal bias (che dobbiamo configurare a 0). Nel progetto passa da 26,95 HU con la bicubica a 18,09 HU dopo il fine-tuning.
PSNR: come RMSE, ma in decibel
Il PSNR (Peak Signal-to-Noise Ratio) confronta l’errore con il valore massimo che l’immagine può assumere, su scala logaritmica come i decibel del suono.
- Più alto è, meglio è. Nel corpo passa da 29,97 a 33,26 dB. Volendo fare un esempio “sonoro” è come il rapporto tra la voce e il rumore in una registrazione. Più voce e meno fruscio danno più dB.
- La calcoliamo in due versioni: “Finestra” usando i valori ristretti alla finestra di visualizzazione cardiaca, cioè quello che siamo abituati a vedere e “Corpo”, contando solo i pixel che abbiano contenuto anatomico, così l’aria intorno non gonfia il risultato.
SSIM: le strutture sono le stesse?
L’SSIM (Structural Similarity) non confronta i singoli pixel. Guarda piccole zone dell’immagine e chiede se luminosità, contrasto e forme coincidono.
Va da 0 a 1, dove 1 indica immagini identiche. Nel progetto passa da 0,9246 a 0,9664. E’ la metrica più vicina a come guarda l’occhio umano. Un’immagine leggermente sfocata può avere un RMSE accettabile, ma solo attraverso la SSIM è possibile avere un confronto serio perché i bordi e le texture non coincidono più.Detto con altre parole, la “dissomiglianza” passa dal 7,5% al 3,4%, dimezzandosi.
Sul test set (2 pazienti, tutte le slice) le metriche sono calcolate rispetto alla Bv44 512×512 reale (che è la nostra ground truth). L’RMSE è in HU sull’intera slice; PSNR e SSIM sono misurati in finestra predefinita (W800 L200), con il PSNR limitato al corpo del paziente (pixel sopra −500 HU) per non avere bias.
| Metodo | RMSE (HU) ↓ | PSNR corpo (dB) ↑ | SSIM ↑ |
|---|---|---|---|
| Bicubica | 26,95 | 29,97 | 0,925 |
| SwinIR zero-shot | 21,73 | 31,84 | 0,956 |
| SwinIR fine-tuned | 18,09 | 33,26 | 0,966 |
Il modello riaddestrato riduce l’errore medio di circa un terzo rispetto alla bicubica e guadagna in media 3,3 dB di PSNR.
La cosa davvero interessante è che anche a livello quantitativo il modello ha migliorato il 100% delle slice del test set. Non c’è un’immagine in cui l’interpolazione bicubica abbia fatto meglio.
Vediamo le immagini
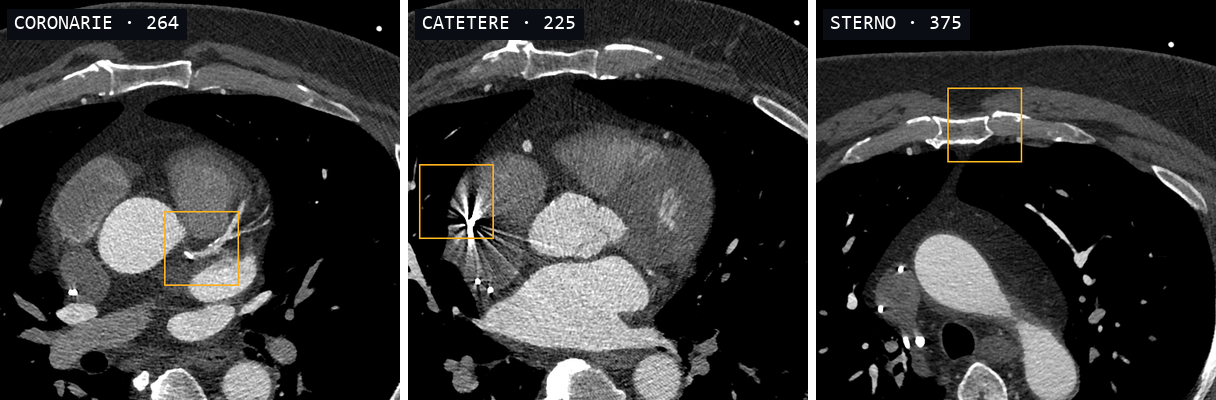
Ho scelto tre punti di tre slice del primo paziente di test, ognuno con una difficoltà diversa. Ogni crop copre 40 × 40 mm ed è ingrandito senza smussare i pixel
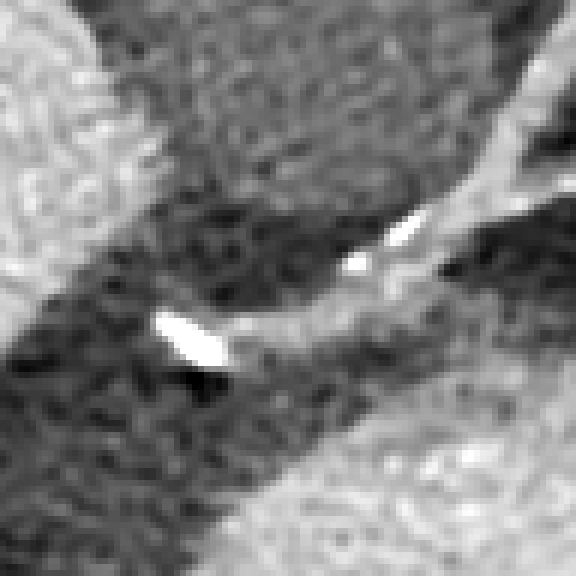
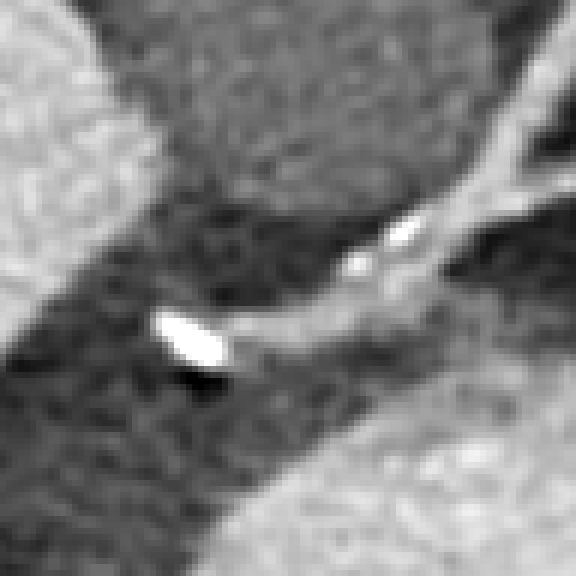
1. Calcificazioni coronariche
 Bicubica
SwinIR
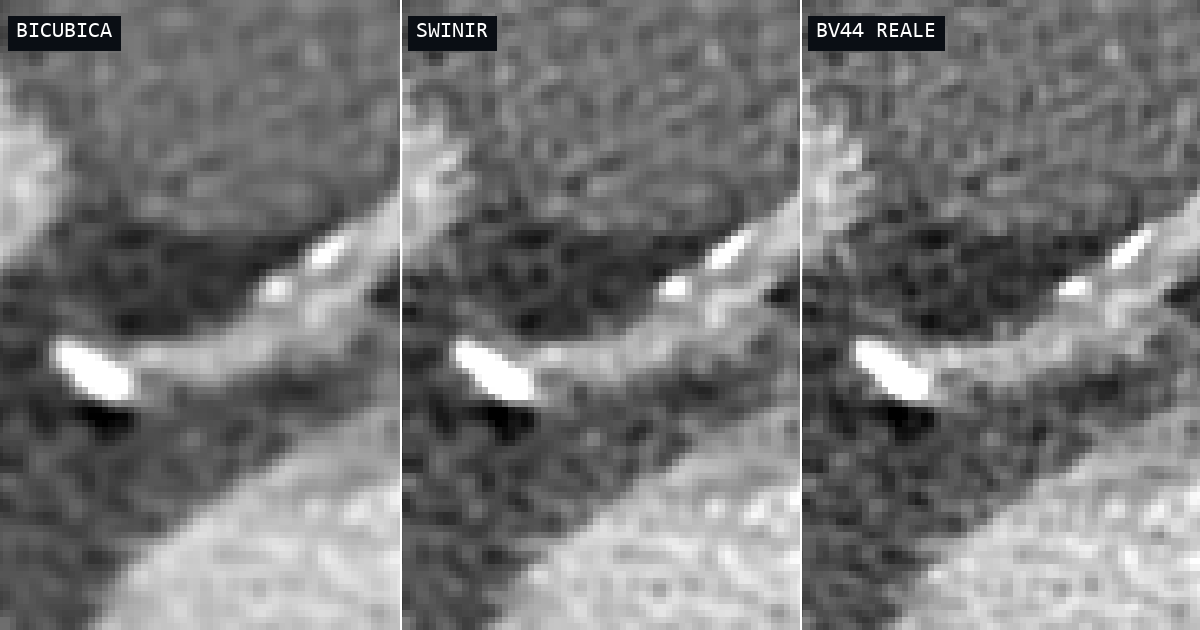
Il risultato dell’interpolazione bicubica è interessante ma dimostra un netto appiattamento dei bordi e un calo importante della risoluzione spaziale; SwinIR restituisce le frequenze originali e parte del rumore del Bv44. Questo è un punto importante da tenere a mente: la rete NON FA denoising ed è una scelta consapevole applicata a priori.
Ricordiamoci che il dataset è stato allestito opportunamente con due kernel diversi e crescenti. Una risoluzione maggiore deve dare più dettaglio anche se più rumore.
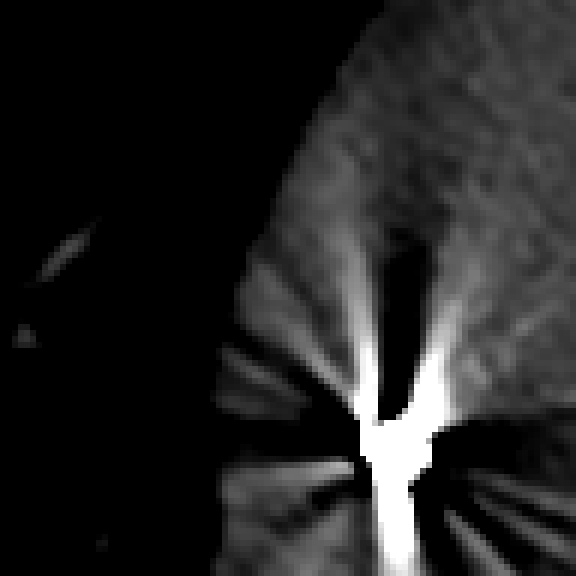
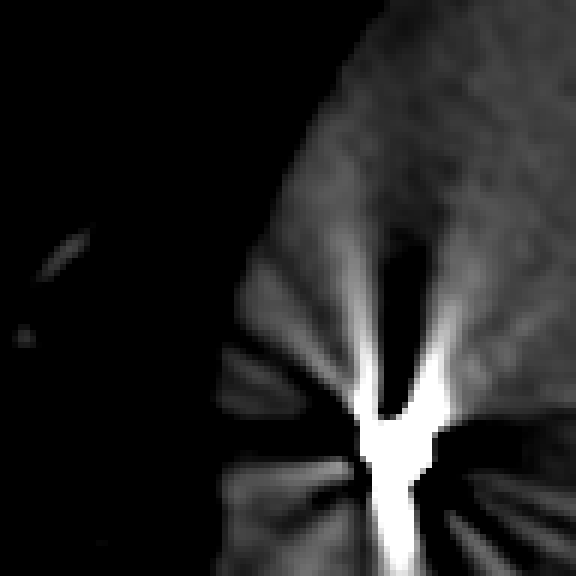
2. Elettrocatetere e artefatto metallico
 Bicubica
SwinIR
Nel dataset è stato anche inserito un congruo numero di slice con artefatti metallici (elettrocateteri di PM o Def) in modo da comprendere se fossero presenti eventuali allucinazioni e valutare visivamente il risultato. Il profilo del catetere e il beam hardening restano coerenti con la Bv44 vera e non compaiono strutture che nella ricostruzione originale non ci sono.
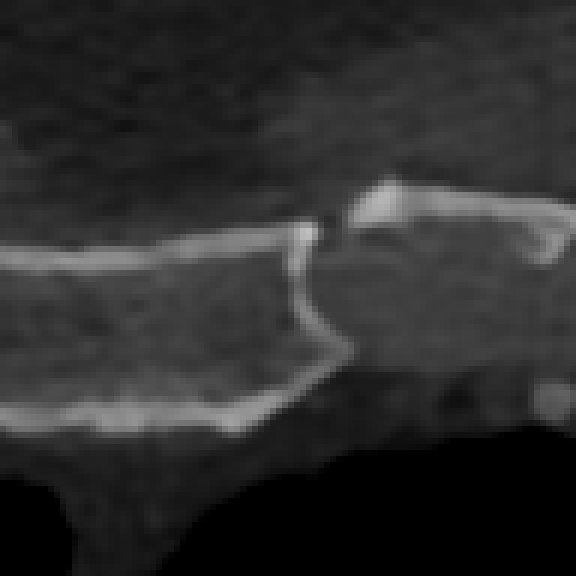
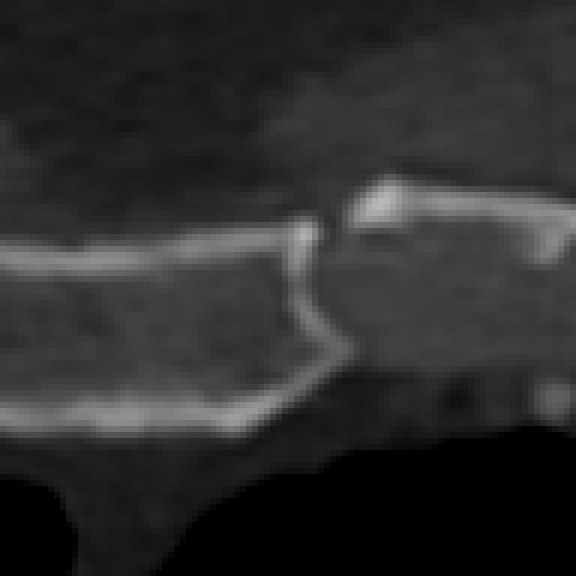
3. Sterno: La prova dell’osso
 Bicubica
SwinIR
Oltre le calcificazioni (utili per comprendere se questo progetto è idoneo per la riduzione del blooming), è interessante valutare il comportamento sulle strutture che già normalmente richiedono un kernel più rigido. E’ in questa circostanza che SwinIR ha ottenuto il risultato migliore dei tre casi (RMSE 12,9 HU contro 20,8 della bicubica).
Il profilo di una calcificazione
Possiamo riassumere i risultati con questo grafico. Più il fianco della curva è ripido, più l’immagine è nitida. La rete riaddetrata in dominio (256->512) ha una progressione quasi sovrapponibile all’immagine di riferimento.
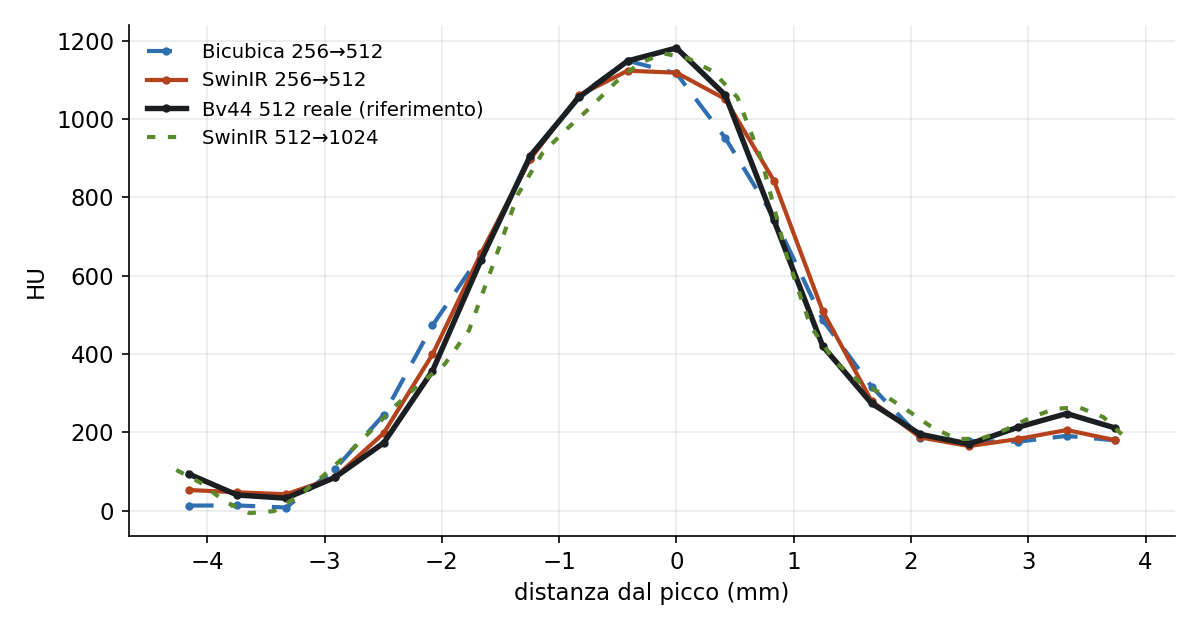
La pendenza massima del fianco passa da circa 630 HU/mm della bicubica a circa 800 HU/mm di SwinIR, in linea con i circa 770 HU/mm della Bv44 vera: la nitidezza torna al livello del kernel di riferimento.
Oltre la matrice nativa: da 512 a 1024
L’esperimento fino ad ora ha confermato la validità della rete neurale nel suo compito nativo x2 e su immagini del suo dominio (passaggio da una matrice di 256×256 a 512×512) ma ci fermiamo qui ?
Nossignore!
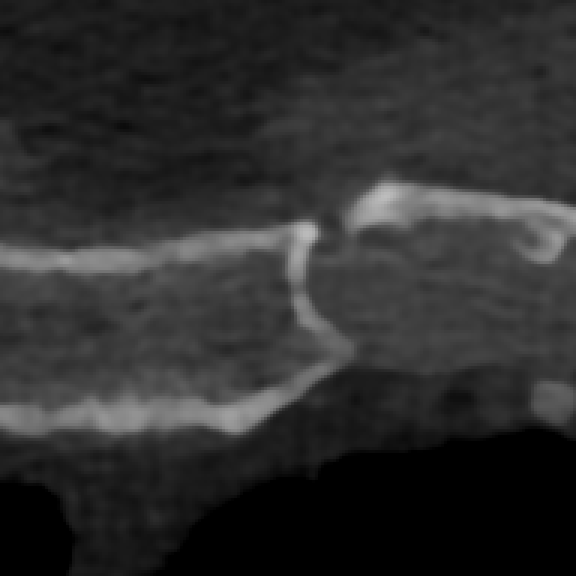
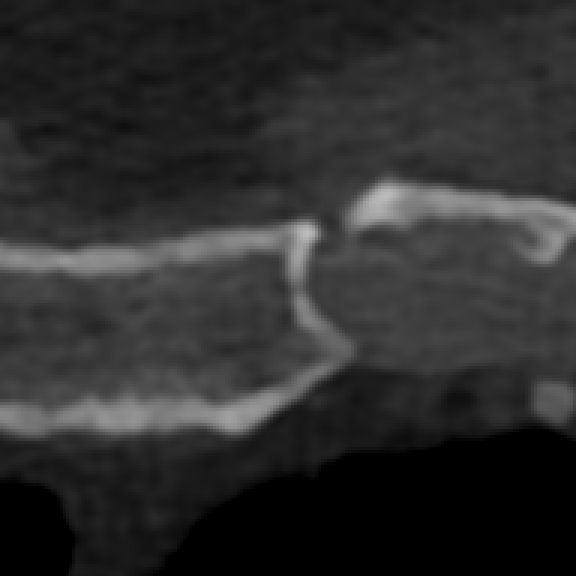
Io sono davvero curioso di vedere cosa accade dando alla rete la Bv44 vera a 512 e chiederle di portarla a 1024, raggiungendo un pixel di circa 0,2 mm.
Il problema è che nel dataset non ci sono ricostruzioni a 1024×1024 con cui confrontarsi, quindi il giudizio rimane solo visivo.
Altro problema: siamo fuori dal dominio di addestramento. La rete non ha mai visto in ingresso pixel così piccoli, né il kernel Bv44.
 Bicubica 1024
SwinIR 1024
L’immagine è più nitida della bicubica, ma anche il rumore viene amplificato. Potrebbe essere interessante riaddestrare la rete con coppie dello stesso kernel e valutarne le differenze.
Codice, pesi e dati
Ho lasciato il lavoro aperto, per chi vuole testarlo, rifarlo, criticarlo o migliorarlo:
- Notebook: Cardiac CT SR x2 — SwinIR Bv40 to Bv44. Contiene il codice completo, dalla lettura dei DICOM alle metriche, con i risultati di questa esecuzione.
- Pesi del modello: il file
swinir_m_x2_cardiacCT_bv40_bv44.pth, tra gli output del notebook (scheda Output). Si caricano nella SwinIR originale con gli stessi parametri del notebook. - Dataset: cardiac-ct-lr-hr, 10 pazienti anonimizzati con le coppie Bv40 a 256 e Bv44 a 512.
Limitazioni attuali
- Pochi pazienti: 10 in tutto, 2 di test, un solo scanner (Siemens Somatom Force) e un solo protocollo. È un esperimento, non una validazione.
- Il 1024 non ha un riferimento
- Le densità cambiano: area e picco delle calcificazioni si spostano rispetto all’originale. Un calcium score calcolato su queste immagini non è confrontabile con l’Agatston standard. In tale circostanza, è comunque opportuno non calcolare l’Agatston standard su dataset fuori dall’intervallo di normalità (Spessore 3mm)
- Non è uno strumento diagnostico: le immagini generate sono derivate e servono a ricerca e didattica. E’ assolutamente inopportuno e soprattutto pericoloso prendere decisioni cliniche sulla base dei risultati di queste elaborazioni.
In conclusione: a cosa può servire
Con un dataset piccolo ma ben appaiato e un’ora e mezza di GPU gratuita su Kaggle, abbiamo imparato come una rete di restauro nata per le fotografie si specializza nell’Imaging medicale e imara a passare da una ricostruzione Bv40 a 256×256 a qualcosa di molto vicino a una Bv44 a 512×512, e lo fa meglio della bicubica su ogni singola slice del test. Ci sono almeno due scenari in cui potrebbe servire.
1. Recuperare archivi a bassa risoluzione. Molti archivi contengono serie ricostruite a matrice ridotta: esami datati, protocolli pensati per risparmiare spazio, ricostruzioni rapide. Molto spesso, nei protocolli cardiaci retrospettivi, le fasi intermedie vengono salvate a matrici ridotte per la “mera” valutazione funzionale e, una rete di questo tipo, potrebbe rivelarsi molto utile a posteriori dalla cancellazione dei dati grezzi.
2. Ottimizzazione delle archiviazioni. Si invia la serie a bassa risoluzione e la si porta ad alta risoluzione solo all’arrivo, pensando alla telerefertazione, alle connessioni lente o al trasferimento tra strutture. Per capire quanto conviene basta guardare il peso dei file. Un DICOM per TC usa 2 byte per pixel, più pochi KB di intestazione, e ogni raddoppio della matrice quadruplica i pixel:
| Matrice | Pixel per slice | Peso per slice | Serie da ~400 slice |
|---|---|---|---|
| 256 × 256 | 65.536 | ~128 KB | ~50 MB |
| 512 × 512 | 262.144 | ~512 KB | ~200 MB |
| 1024 × 1024 | 1.048.576 | ~2 MB | ~800 MB |
Da 256 a 1024 i dati diventano 16 volte più grandi: trasferire la serie a 256 e ricostruirla a destinazione vuol dire muovere 50 MB invece di 800. Con la compressione lossless (JPEG-LS o JPEG 2000) i numeri assoluti scendono di 2–3 volte, ma il rapporto resta più o meno lo stesso.
Ci sono però due avvertenze, che questo esperimento non risolve:
- La degradazione deve essere quella giusta. Qui la 256 è una vera ricostruzione dello scanner a partire dai dati grezzi, non una 512 rimpicciolita. Un DICOM già ricostruito e poi ridotto produce un’immagine diversa, e la rete andrebbe rifinita su coppie create esattamente in quel modo. La buona notizia è che queste coppie si generano facilmente, senza bisogno dei dati grezzi.
- Il 1024 non è validato. Non avevo a disposizione una ricostruzione reale a 1024 con cui confrontarmi: la rete aggiunge dettaglio plausibile (non necessariamente vero). Per qualunque uso clinico, l’originale deve restare quello di riferimento, e l’immagine super-risolta un derivato chiaramente etichettato come tale.
Notebook, pesi e dataset sono pubblici: se avete dati accoppiati e volete provarci, scrivetemi o lasciate un commento! Alla prossima!